Academic Portfolio

Yang
Chen

Researcher at Shanghai AI Lab working across reinforcement learning, multi-agent systems, game theory, and LLM-based reasoning.

Bio

I obtained my PhD in computer science from the University of Auckland, after completing First Class Honours there in 2018. Before moving to New Zealand, I received my B.S. in computer science from Beijing Institute of Technology.

My research spans reinforcement learning, multi-agent systems and game theory. A central thread is reward learning from data, where I focus on both algorithmic design and applications. More recently, I have focused on LLMs, behaviour modelling, ethical AI, and responsible AI.

Outside research and teaching, I spend time hiking and making photographs. That visual sensibility matters to how I present research too: clarity, sequence, atmosphere, and strong composition. These photo collections are archived in my personal online gallery.

Experience

Appointments

Jul 2025 - Present
ResearcherShanghai AI Lab
Oct 2024 - Jul 2025
Senior Research AssociateUniversity of New South Wales
Jun 2021 - Sep 2024
Research FellowUniversity of Auckland

Visiting and Industry

Oct 2024
Visiting researcherUniversity of Copenhagen
Sep 2020 - Jan 2021
Research InternAlibaba DAMO Academy

Education

Nov 2018 - Sep 2022
PhD in Computer ScienceUniversity of Auckland
Jul 2017 - Jul 2018
First Class Honours in Computer ScienceUniversity of Auckland
Aug 2013 - Jun 2017
BSc in Computer Science and TechnologyBeijing Institute of Technology

Talks & Teaching

Talks

From One to Infinity: New Perspectives and Methods for Inverse Reinforcement Learning

University of Copenhagen. Denmark. 8 October 2024.

Towards Many-agent Inverse Reinforcement Learning via Mean Field Games

DAI 2023. Singapore. 2 December 2023.

Promotional talk for AAMAS 2024 at the closing session of AAMAS 2023

AAMAS 2023. London. 2 June 2023.

Mean Field Game as a Framework for Many-agent Inverse Reinforcement Learning

ML and MFG seminar. Online. 6 December 2022.

Teaching

Awards, Grants & Services

Awards & Grants

Recipient of Shanghai Overseas Young Talent Program 2026

Google Global PhD Fellowship Nomination (Australia & New Zealand), 2020

University of Auckland Doctoral Scholarship

November 2018 - November 2021

Academic Service

Conference Area Chair

NeurIPS 2026. DAI 2026.

Conference Reviewer

ICML 2026, ICLR 2025-2026, NeurIPS 2025, AAAI 2026-2027, IJCAI 2025, ACL 2024-2026, AAMAS 2023-2025, ECAI 2024-2025, COLM 2025-2026.

Journal Reviewer

Journal of Machine Learning Research.

Projects

Agent Panel

The world's first "Research Moltbook x AI Agent Quora" community, centered on one question, many answers, and multi-agent discussion.

Selected Publications

Also see my Google Scholar page for the full list of my publications.
Classical Reinforcement Learning & Imitation Learning

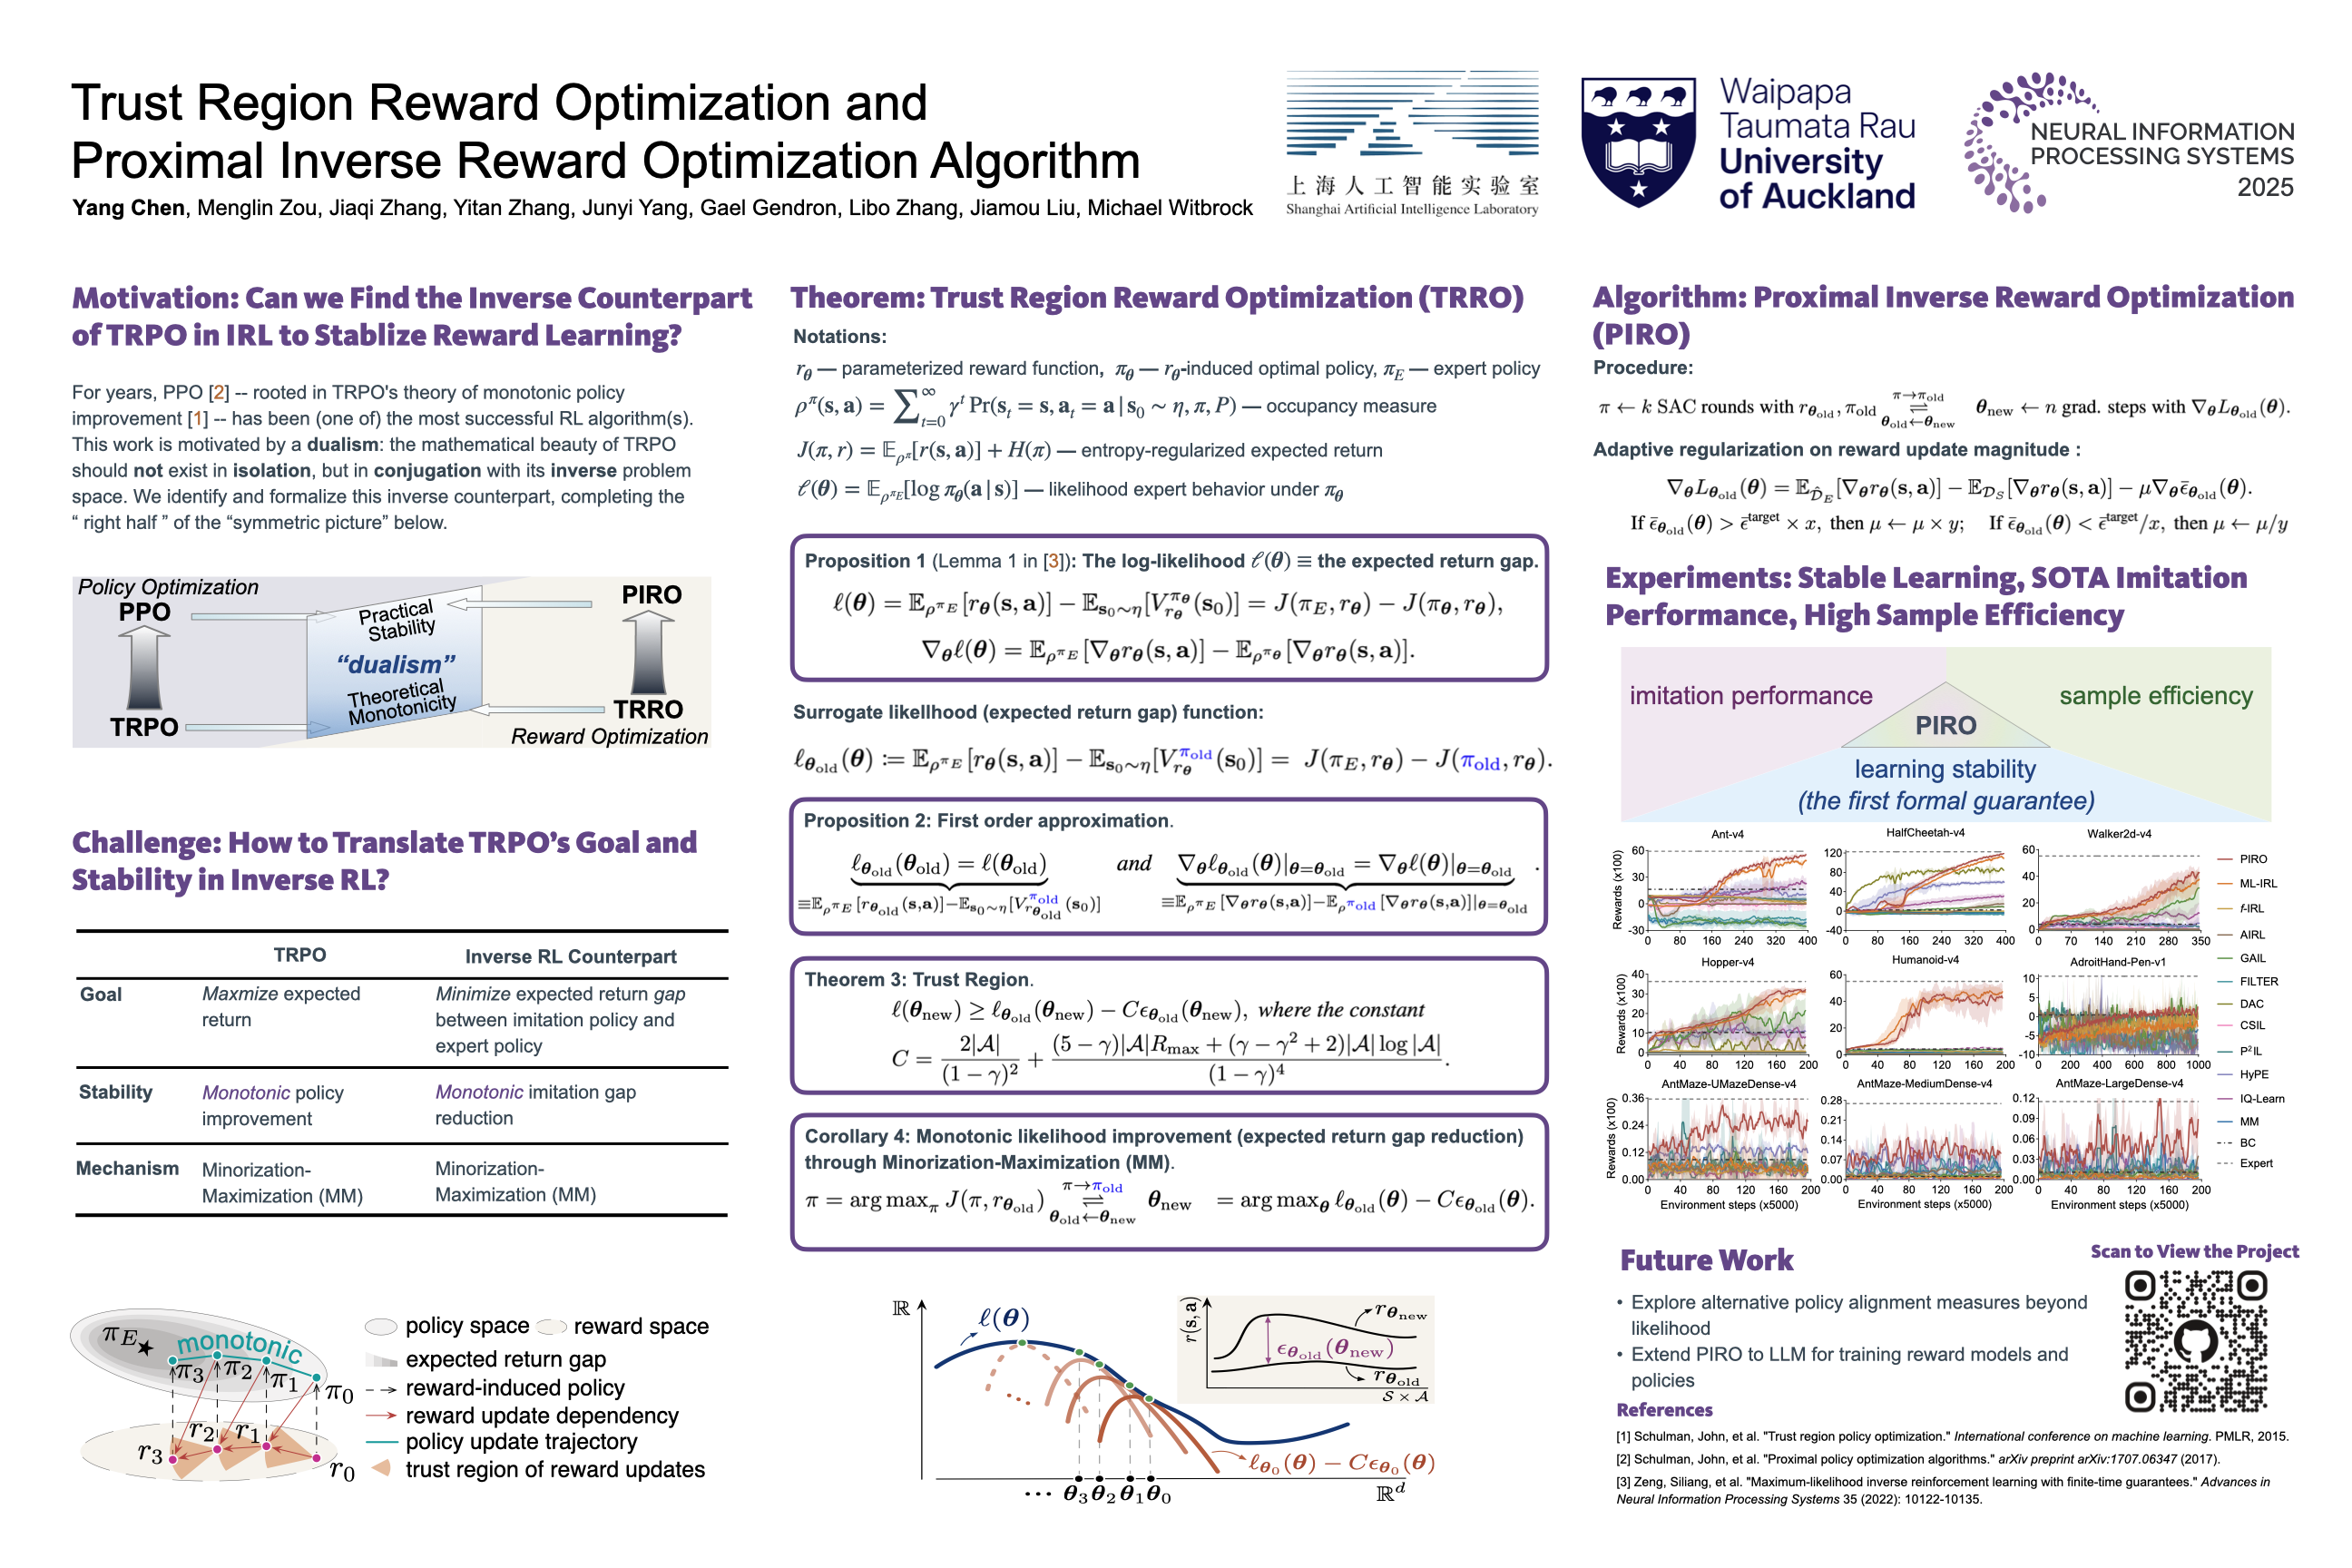
  • Trust Region Reward Optimization and Proximal Inverse Reward Optimization Algorithm. Yang Chen, Menglin Zou, Jiaqi Zhang, Yitan Zhang, Junyi Yang, Gael Gendron, Libo Zhang, Jiamou Liu, Michael Witbrock.
  • Situational-Constrained Sequential Resources Allocation via Reinforcement Learning. Libo Zhang, Yang Chen, Toru Takisaka, Kaiqi Zhao, Weidong Li, Jiamou Liu.
  • Meta-Inverse Reinforcement Learning for Mean Field Games with Probabilistic Context Variables. Yang Chen, Xiao Lin, Bo Yan, Libo Zhang, Jiamou Liu, Neset Ozkan Tan, Michael Witbrock.
  • Density-based Correlated Equilibrium for Markov Games. Libo Zhang (equal contribution), Yang Chen (contact, equal contribution), Toru Takisaka, Bakh Khoussainov, Michael Witbrock, Jiamou Liu.
  • Adversarial Inverse Reinforcement Learning for Mean Field Games. Yang Chen, Libo Zhang, Jiamou Liu, Michael Witbrock.
  • Individual-Level Inverse Reinforcement Learning for Mean Field Games. Yang Chen, Libo Zhang, Jiamou Liu, Shuyue Hu.

(Reinforcement) Learning in Large Language Models

  • LLMRouterBench: A Massive Benchmark and Unified Framework for LLM Routing. Hao Li, Yiqun Zhang, Zhaoyan Guo, Chenxu Wang, Shengji Tang, Qiaosheng Zhang, Yang Chen, Biqing Qi, Peng Ye, Lei Bai, Zhen Wang, Shuyue Hu.
  • Beyond Scalar Critics: A Distributional Perspective on Reinforcement Learning with Verifiable Rewards for LLMs. Jinyi Liu, Yiboyun Chen, Hongyao Tang, Yi Ma, Shuyue Hu, Yang Chen, Fei Ni, Qiaosheng Zhang, Lei Bai, Yan Zheng, Jianye Hao.
  • CraftUtopia: A LLM-based Multi-Agent System for Collaborative Construction in Minecraft. Wanli Fu, Hao Li, Siyue Ren, XingChenxi, Yang Chen, Chu Chen, Zhen Wang, Shuyue Hu.
  • The Landscape of Agentic Reinforcement Learning for LLMs: A Survey. Guibin Zhang, Hejia Geng, Xiaohang Yu, Zhenfei Yin, Zaibin Zhang, Zelin Tan, Heng Zhou, Zhongzhi Li, Xiangyuan Xue, Yijiang Li, Yifan Zhou, Yang Chen, Chen Zhang, Yutao Fan, Zihu Wang, Songtao Huang, Yue Liao, Hongru Wang, Mengyue Yang, Heng Ji, Michael Littman, Jun Wang, Shuicheng Yan, Philip Torr, Lei Bai.
  • Do We Truly Need So Many Samples? Multi-LLM Repeated Sampling Efficiency Scales Test-Time Compute. Jianhao Chen, Zishuo Xun, Bocheng Zhou, Qiaosheng Zhang, Yang Chen, Wei Hu, Yuzhong Qu, Wanli Ouyang, Shuyue Hu.

Reasoning in Language Models

  • Assessing and Enhancing the Robustness of Large Language Models with Task Structure Variations for Logical Reasoning. Qiming Bao, Gael Gendron, Alex Peng, Wanjun Zhong, Neset Tan, Yang Chen, Michael Witbrock, Jiamou Liu.
  • Abstract Meaning Representation-Based Logic-Driven Data Augmentation for Logical Reasoning. Qiming Bao, Alex Yuxuan Peng, Zhenyun Deng, Wanjun Zhong, Gael Gendron, Timothy Pistotti, Neset Tan, Nathan Young, Yang Chen, Yonghua Zhu, Paul Denny, Michael Witbrock, Jiamou Liu.
  • Neuromodulation Gated Transformer. Kobe Knowles, Joshua Bensemann, Diana Benavides Prado, Vithya Yogarajan, Michael Witbrock, Gillian Dobbie, Yang Chen.
  • Multi2Claim: Generating Scientific Claims from Multi-Choice Questions for Scientific Fact-Checking. Neset Tan, Trung Nguyen, Josh Bensemann, Alex Peng, Qiming Bao, Yang Chen, Mark Gahegan, Michael Witbrock.
  • Interpretable AMR-Based Question Decomposition for Multi-hop Question Answering. Zhenyun Deng, Yonghua Zhu, Yang Chen, Michael Witbrock, Patricia Riddle.
  • Prompt-based Conservation Learning for Multi-hop Question Answering. Zhenyun Deng, Yonghua Zhu, Yang Chen, Qianqian Qi, Michael Witbrock, Patricia Riddle.